
Memahami Apa Itu Robots Txt SEO: Panduan Lengkap untuk Efisiensi Aset Digital Bisnis Anda
Pendahuluan: Pentingnya Pengaturan Visibilitas Website di Era Digital
Di era transformasi digital saat ini, memiliki situs web bukan sekadar syarat kelengkapan bisnis, melainkan sebuah aset yang harus dikelola secara efisien. Setiap halaman yang terindeks oleh mesin pencari seperti Google memiliki peran strategis dalam menarik calon pelanggan. Namun, tidak semua halaman di dalam situs web perlu dipublikasikan atau diakses oleh publik dan mesin pencari.
Banyak pemilik usaha dan pengelola situs web menghadapi kendala ketika halaman internal seperti panel admin, keranjang belanja, atau halaman pencarian internal justru muncul di hasil pencarian. Masalah ini umumnya berakar dari kurangnya pemahaman tentang pengelolaan akses perayap (search engine crawler).
Untuk mengatasi tantangan tersebut, pemahaman mendalam tentang apa itu robots txt seo menjadi faktor kunci dalam optimasi teknis situs web. Melalui pengelolaan file instruksi ini, pelaku bisnis dapat mengarahkan lalu lintas mesin pencari secara lebih terstruktur dan efisien.
Artikel ini akan membahas secara komprehensif mengenai fungsi, manfaat, strategi penerapan, hingga kesalahan umum dalam pengelolaan file robots.txt untuk mendukung kinerja aset digital Anda.
Definisi dan Konsep Dasar Robots.txt dalam SEO
Apa Itu Robots.txt?
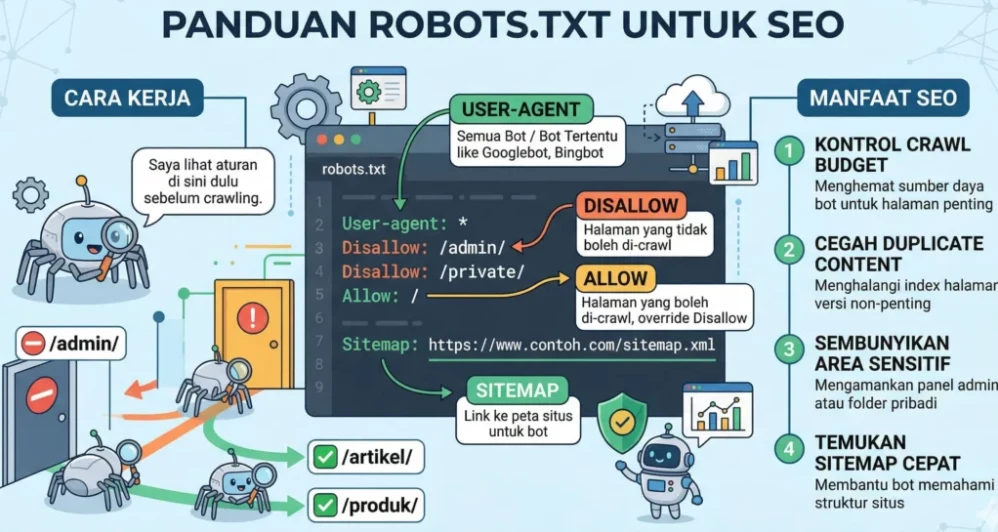
Secara teknis, robots.txt adalah sebuah file teks sederhana berformat .txt yang ditempatkan di direktori utama (root directory) sebuah situs web. File ini berfungsi memberikan petunjuk atau instruksi kepada bot perayap (web crawlers atau spiders) mengenai halaman mana saja yang boleh dan tidak boleh diakses.
Dalam konteks pemasaran digital, memahami apa itu robots txt seo merujuk pada praktik mengoptimalkan instruksi dalam file tersebut agar mesin pencari memprioritaskan halaman-halaman penting yang berpotensi menghasilkan konversi bisnis.
File ini menggunakan Robots Exclusion Standard, sebuah protokol independen yang disepakati oleh platform mesin pencari utama di seluruh dunia.
User-agent: *
Disallow: /admin/
Allow: /
Sitemap: https://www.contohbisnis.com/sitemap.xml
Cara Kerja Perayap Mesin Pencari
Ketika bot mesin pencari seperti Googlebot mengunjungi sebuah situs web, langkah pertama yang dilakukan adalah mencari dan membaca file robots.txt. Bot akan mengurai instruksi yang ada di dalam file tersebut sebelum melanjutkan proses pemindaian konten.
Jika sebuah jalur (path) ditandai dengan instruksi dibatasi (Disallow), maka bot akan melewati direktori tersebut. Sebaliknya, jika direktori diizinkan (Allow), bot akan melanjutkan proses perayapan konten secara normal.
Perbedaan Utama Antara Crawling dan Indexing
Salah satu kesalahpahaman umum dalam pengelolaan aset digital adalah menyamakan proses perayapan (crawling) dengan penjelajahan untuk pendaftaran indeks (indexing).
- Crawling: Proses di mana bot mesin pencari menjelajahi dan mengunduh konten dari suatu halaman web.
- Indexing: Proses menyimpan, menganalisis, dan menampilkan halaman web tersebut ke dalam basis data hasil pencarian.
File robots.txt secara primer mengontrol proses crawling, bukan secara langsung mencegah indexing. Jika sebuah halaman yang diblokir di robots.txt memiliki tautan dari situs web eksternal lain, Google masih mungkin memasukkan URL tersebut ke dalam indeks tanpa membaca isi kontennya.
Sintaks Dasar dan Komponen Utama File Robots.txt
Untuk memahami cara kerja pengelolaan ini secara mendalam, penting untuk mengenali komponen-komponen dasar yang menyusun perintah di dalamnya.
+-----------------------------------------------------------------------+
|                       STRUKTUR PERINTAH ROBOTS.TXT                     |
+-----------------------------------------------------------------------+
|                                                                       |
|      ---> Menentukan bot mana yang diatur              |
|                                (Contoh: * berarti semua bot)          |
|                                                                       |
|   ---> Melarang akses ke direktori/halaman tertentu |
|                                                                       |
|      ---> Mengizinkan akses ke sub-direktori spesifik  |
|                                                                       |
|       ---> Menunjukkan lokasi peta situs XML            |
|                                                                       |
+-----------------------------------------------------------------------+
1. User-agent
Sintaks ini menentukan untuk siapa instruksi tersebut ditujukan. Anda bisa menetapkan aturan untuk semua bot mesin pencari atau secara spesifik untuk bot tertentu.
User-agent: *(Berlaku untuk semua jenis bot mesin pencari)User-agent: Googlebot(Hanya berlaku untuk bot utama Google)User-agent: Bingbot(Hanya berlaku untuk bot milik Bing)
2. Disallow
Perintah ini digunakan untuk melarang bot mengakses folder, direktori, atau halaman tertentu di dalam situs web.
Disallow: /(Melarang bot mengakses seluruh isi situs web)Disallow: /privasi/(Melarang bot mengakses folder privasi)
3. Allow
Perintah ini digunakan untuk memberikan izin akses ke halaman atau sub-folder tertentu yang berada di dalam direktori yang sebelumnya telah diblokir.
Allow: /privasi/kebijakan-publik.html(Mengizinkan halaman spesifik ini meskipun folder/privasi/diblokir)
4. Sitemap
Mencantumkan lokasi XML Sitemap di dalam file robots.txt membantu mesin pencari menemukan peta struktur situs web dengan lebih cepat dan efisien.
Sitemap: https://www.domainbisnis.com/sitemap.xml
Manfaat dan Tujuan Penggunaan Robots.txt untuk Bisnis Digital
Pengelolaan file instruksi perayapan yang tepat memberikan dampak langsung pada efisiensi operasional dan performa pemasaran digital suatu perusahaan.
                                  +---------------------------------------+
                                  | MANFAAT PENGGUNAAN ROBOTS.TXT SEO     |
                                  +---------------------------------------+
                                                      |
         +--------------------------------------------+--------------------------------------------+
         |                                            |                                            |
         v                                            v                                            v
+----------------------------------+     +----------------------------------+     +----------------------------------+
| Optimasi Crawl Budget            |     | Perlindungan Beban Server        |     | Pencegahan Kanibalisasi Konten   |
| Menjamin alokasi pemindaian bot  |     | Mengurangi penggunaan bandwidth  |     | Memblokir halaman duplikat dan   |
| fokus pada halaman utama bisnis. |     | dari pemindaian berlebihan.      |     | parameter pencarian internal.    |
+----------------------------------+     +----------------------------------+     +----------------------------------+
1. Mengoptimalkan Crawl Budget Bisnis Anda
Setiap situs web memiliki alokasi waktu dan sumber daya tertentu dari mesin pencari yang dikenal dengan istilah crawl budget. Bot tidak akan menjelajahi jutaan halaman di situs Anda secara tanpa batas dalam satu waktu.
Jika mesin pencari menghabiskan alokasi waktu tersebut untuk memindai ribuan halaman yang tidak penting, halaman produk atau artikel utama Anda berisiko tidak terindeks dengan cepat. Dengan menerapkan apa itu robots txt seo secara efisien, Anda memastikan bahwa bot memfokuskan sumber dayanya pada halaman yang menghasilkan nilai bisnis.
2. Mencegah Beban Server Berlebihan
Aktivitas perayapan dari puluhan bot secara bersamaan dapat meningkatkan penggunaan CPU dan bandwidth server web. Pada situs e-commerce skala besar, pemindaian yang terlalu agresif dapat memperlambat kinerja situs bagi pengunjung nyata.
Aturan yang jelas di dalam robots.txt membantu mengontrol frekuensi dan area pemindaian, sehingga performa server tetap stabil dan responsif.
3. Menghindari Indeksasi Halaman Duplikat atau Filter Produk
Platform e-commerce sering kali memiliki fitur penyaringan (filter) produk berdasarkan warna, ukuran, atau harga yang menghasilkan puluhan URL berulang dengan konten serupa. Pemblokiran parameter URL ini melalui instruksi perayapan mencegah penurunan kualitas nilai SEO akibat masalah duplikasi konten.
Tabel Perbandingan: Penggunaan Robots.txt yang Tepat vs. Tidak Tepat
| Parameter | Penerapan yang Tepat (Optimal) | Penerapan yang Tidak Tepat (Beresiko) |
|---|---|---|
| Akses Halaman Utama | Diizinkan penuh (Allow: /) |
Terblokir secara tidak sengaja (Disallow: /) |
| File CSS & JavaScript | Diizinkan agar rendering sempurna | Diblokir, menyebabkan tampilan rusak di mata bot |
| Halaman Area Pribadi | Diblokir dari pemindaian | Dibiarkan terbuka untuk dipindai publik |
| Pengamanan Data Sensitif | Menggunakan enkripsi & otentikasi login | Hanya mengandalkan pemblokiran robots.txt |
| Peta Situs (Sitemap) | Ditentukan dengan jelas di baris akhir | Tidak dicantumkan sama sekali |
Risiko dan Pertimbangan Penting Sebelum Mengonfigurasi
Meskipun terlihat sederhana, kesalahan kecil pada tata bahasa (syntax) file robots.txt dapat membawa dampak buruk bagi visibilitas bisnis secara keseluruhan.
1. Risiko Kehilangan Trafik Organik Secara Total
Kesalahan berupa penulisan Disallow: / pada User-agent: * akan memerintahkan mesin pencari untuk berhenti memindai seluruh bagian situs web. Dalam beberapa minggu, halaman web dapat hilang dari hasil pencarian, yang berpotensi menurunkan pendapatan bisnis secara drastis.
2. Mispersepsi Keamanan Data (Security Misconception)
Satu hal mendasar yang harus dipahami adalah bahwa file robots.txt bersifat publik. Siapa pun dapat mengakses file ini dengan mengetikkan domain.com/robots.txt di peramban mereka.
Oleh karena itu, file ini bukan merupakan alat pengamanan data. Memblokir folder seperti /data-keuangan/ di robots.txt justru memberi tahu pihak luar lokasi folder sensitif tersebut tanpa memberikan perlindungan sandi apa pun.
3. Penundaan Pembaruan Indeks
Jika Anda memperbarui konten pada halaman yang terlanjur diblokir oleh robots.txt, mesin pencari tidak akan dapat memindai perubahan terbaru tersebut. Akibatnya, informasi lama tetap tersimpan di dalam basis data pencarian hingga akses perayapan dibuka kembali.
Strategi Pengelolaan Robots.txt untuk Skala Bisnis dan UMKM
Pengelolaan aspek teknis SEO tidak harus rumit. Pelaku usaha mikro, kecil, dan menengah (UMKM) maupun tim TI perusahaan dapat menerapkan pendekatan terstruktur berikut.
+-----------------------------------------------------------------------+
|              TAHAPAN STRATEGI PENGELOLAAN ROBOTS.TXT                  |
+-----------------------------------------------------------------------+
|                                                                       |
|  1. Audit Struktur URL   ---> Identifikasi direktori publik vs privat |
|                                                                       |
|  2. Penyusunan Instruksi ---> Buat aturan Allow & Disallow yang presisi|
|                                                                       |
|  3. Pengujian Sintaks    ---> Validasi via Google Search Console      |
|                                                                       |
|  4. Pemantauan Berkala   ---> Evaluasi dampak pasca pembaruan situs   |
|                                                                       |
+-----------------------------------------------------------------------+
1. Mengidentifikasi Halaman yang Perlu Diblokir
Lakukan audit internal terhadap struktur URL situs web Anda. Halaman-halaman berikut umumnya disarankan untuk dibatasi akses perayapannya:
- Halaman hasil pencarian internal situs (
/search?q=) - Halaman keranjang belanja dan proses pembayaran (checkout)
- Halaman registrasi, konfirmasi akun, dan portal login anggota
- File sistem internal CMS (misalnya
/wp-admin/pada platform WordPress) - Halaman uji coba (staging environment)
2. Mengizinkan Akses Resource Pendukung
Mesin pencari modern tidak hanya membaca teks, tetapi juga melakukan proses pembacaan tampilan (rendering) seperti peramban manusia. Memblokir file CSS, JavaScript, atau gambar dapat menyebabkan bot gagal memahami bahwa situs web Anda sudah ramah perangkat seluler (mobile-friendly).
Pastikan direktori yang menyimpan aset visual dan skrip kode tetap dapat diakses oleh User-agent.
3. Mengintegrasikan Peta Situs XML
Selalu sertakan tautan langsung ke XML Sitemap Anda di bagian bawah file. Hal ini mempermudah bot menemukan indeks struktur halaman resmi yang telah Anda persiapkan untuk publikasi.
Contoh Penerapan Kasus Bisnis Sektor Digital
Berikut adalah beberapa contoh praktis penerapan file robots.txt berdasarkan model bisnis yang berbeda.
Contoh 1: Situs Profil Perusahaan (Company Profile / Lead Generation)
Pada situs profil perusahaan, fokus utamanya adalah memastikan seluruh halaman layanan dan artikel blog terindeks sempurna, sementara sistem internal tetap terlindungi dari aktivitas pemindaian.
User-agent: *
Disallow: /wp-admin/
Disallow: /includes/
Disallow: /trackback/
Disallow: /xmlrpc.php
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.perusahaananda.com/sitemap.xml
Contoh 2: Situs Toko Online (E-Commerce)
Situs e-commerce memiliki kompleksitas yang lebih tinggi karena banyaknya direktori internal, halaman sistem pengguna, dan fungsi pencarian produk.
User-agent: *
Disallow: /checkout/
Disallow: /cart/
Disallow: /account/
Disallow: /search/
Disallow: /*?sort=
Disallow: /*?price=
Allow: /media/

Sitemap: https://www.tokoonlineanda.com/sitemap_index.xml
Kesalahan Umum dalam Mengelola Robots.txt
Untuk menjaga kinerja keterlihatan situs web tetap optimal, hindari kesalahan-kesalahan kritis berikut dalam operasional harian:
+-----------------------------------------------------------------------+
|                    KESALAHAN UMUM YANG HARUS DIHINDARI                |
+-----------------------------------------------------------------------+
|  Penggunaan Karakter Huruf Besar/Kecil yang Tidak Konsisten        |
|     (Linux server bersifat case-sensitive: /Admin != /admin)          |
|                                                                       |
|  Memblokir File CSS dan JS                                         |
|     (Mengganggu proses rendering tampilan visual situs oleh bot)      |
|                                                                       |
|  Menandai Halaman Privat Hanya dengan Disallow                     |
|     (Gunakan otentikasi kata sandi untuk pengamanan data sebenarnya)  |
|                                                                       |
|  Menuliskan Banyak Sintaks User-agent Tanpa Pemisah yang Jelas     |
|     (Dapat menyebabkan pembacaan aturan menjadi tumpang tindih)      |
+-----------------------------------------------------------------------+
1. Masalah Sensitivitas Huruf (Case Sensitivity)
File robots.txt diproses berdasarkan aturan case-sensitive. Artinya, sintaks Disallow: /Admin/ tidak akan melindungi folder /admin/. Pastikan penulisan URL sesuai persis dengan struktur direktori di server Anda.
2. Memblokir Halaman yang Ingin Dihapus dari Google
Jika Anda ingin menghapus halaman tertentu dari hasil pencarian Google, memblokirnya via robots.txt bukan cara yang tepat. Gunakan arahan Meta Tag Noindex di dalam header HTML halaman tersebut, dan biarkan bot memindainya sekali lagi agar perintah penarikan indeks dapat diproses.
3. Tidak Melakukan Pengujian Pasca Perubahan
Mengunggah file tanpa verifikasi teknis berisiko menimbulkan masalah tak terduga. Manfaatkan fitur Robots Testing Tool yang tersedia di dalam Google Search Console untuk memastikan bahwa aturan yang baru dibuat bekerja sesuai rencana.
Kesimpulan dan Ringkasan Insight Utama
Memahami apa itu robots txt seo merupakan fondasi teknis yang amat penting bagi siapa saja yang mengelola aset web secara profesional. File sederhana ini berfungsi sebagai pengatur lalu lintas perayapan yang menentukan seberapa efisien mesin pencari memahami dan memindai struktur situs Anda.
Berikut adalah poin-poin kunci yang perlu diingat:
- File
robots.txtmengontrol akses perayapan (crawling), bukan secara mutlak menghentikan pendaftaran indeks (indexing). - Penggunaan instruksi yang tepat membantu menghemat crawl budget, menjaga performa server, dan menghindari duplikasi konten pada situs web bisnis.
- File ini bersifat terbuka untuk publik dan tidak boleh digunakan sebagai instrumen keamanan data sensitif utama.
- Pastikan file CSS dan JavaScript tidak terblokir agar mesin pencari dapat menilai responsivitas tampilan situs secara akurat.
- Uji setiap pembaruan file secara berkala melalui platform analisis resmi seperti Google Search Console.
Dengan menerapkan prinsip tata kelola yang terstruktur, efisien, dan objektif pada file robots.txt, Anda dapat mengoptimalkan potensi aset digital perusahaan untuk mendukung pertumbuhan bisnis jangka panjang.